Ứng dụng AI cho phòng sale không thể hoạt động hiệu quả nếu doanh nghiệp chỉ mua một công cụ thông minh rồi kỳ vọng phòng sale tự động bán hàng tốt hơn. Thực tế không đơn giản như vậy. Để một ứng dụng AI cho phòng sale hoạt động đúng, bạn cần một nền dữ liệu sạch và một đường ống dẫn dữ liệu vững chắc. Đây là phần việc của đội kỹ thuật, không phải của thuật toán. Trong bài viết này, chúng tôi sẽ giải thích cho bạn từng bước cần chuẩn bị.
Vì sao ứng dụng AI cho phòng sale cần dữ liệu tốt trước tiên
Trước khi nói đến AI, hãy nói về dữ liệu. Mọi mô hình thông minh đều học từ dữ liệu bạn đưa vào. Nếu dữ liệu xấu, kết quả cũng xấu theo. Dân tech có một câu quen thuộc cho việc này: rác vào thì rác ra.
Một ứng dụng AI cho phòng sale chỉ phát huy giá trị khi nguồn dữ liệu nền tảng được làm sạch. Vì vậy đây là bài toán kỹ thuật trước khi là bài toán mô hình. Bạn cần xử lý gốc rễ thay vì chạy theo công cụ.
Dữ liệu CRM rời rạc, trùng lặp và thiếu chuẩn hoá khiến mô hình dự đoán sai
Hệ thống CRM của nhiều doanh nghiệp lưu dữ liệu rất lộn xộn. Một khách hàng có thể xuất hiện ở ba bản ghi khác nhau. Số điện thoại nhập sai định dạng. Tên công ty viết theo nhiều kiểu.
Những lỗi này nghe có vẻ nhỏ. Nhưng khi mô hình học từ dữ liệu trùng lặp, nó sẽ đếm sai. Khi định dạng không thống nhất, nó sẽ hiểu nhầm. Kết quả là dự đoán doanh số lệch và chấm điểm lead thiếu chính xác.
Các vấn đề thường gặp trong dữ liệu CRM gồm có:
- Bản ghi trùng do nhập tay nhiều lần
- Trường dữ liệu để trống hoặc nhập tạm cho xong
- Định dạng ngày, số điện thoại và email không thống nhất
- Thông tin cũ không được cập nhật sau khi khách thay đổi
Vai trò của đội tech trong việc làm sạch và hợp nhất nguồn dữ liệu khách hàng
Đây là lúc đội kỹ thuật bước vào. Nhiệm vụ đầu tiên là làm sạch dữ liệu. Họ gộp các bản ghi trùng về một khách hàng duy nhất. Họ chuẩn hoá định dạng cho mọi trường quan trọng.
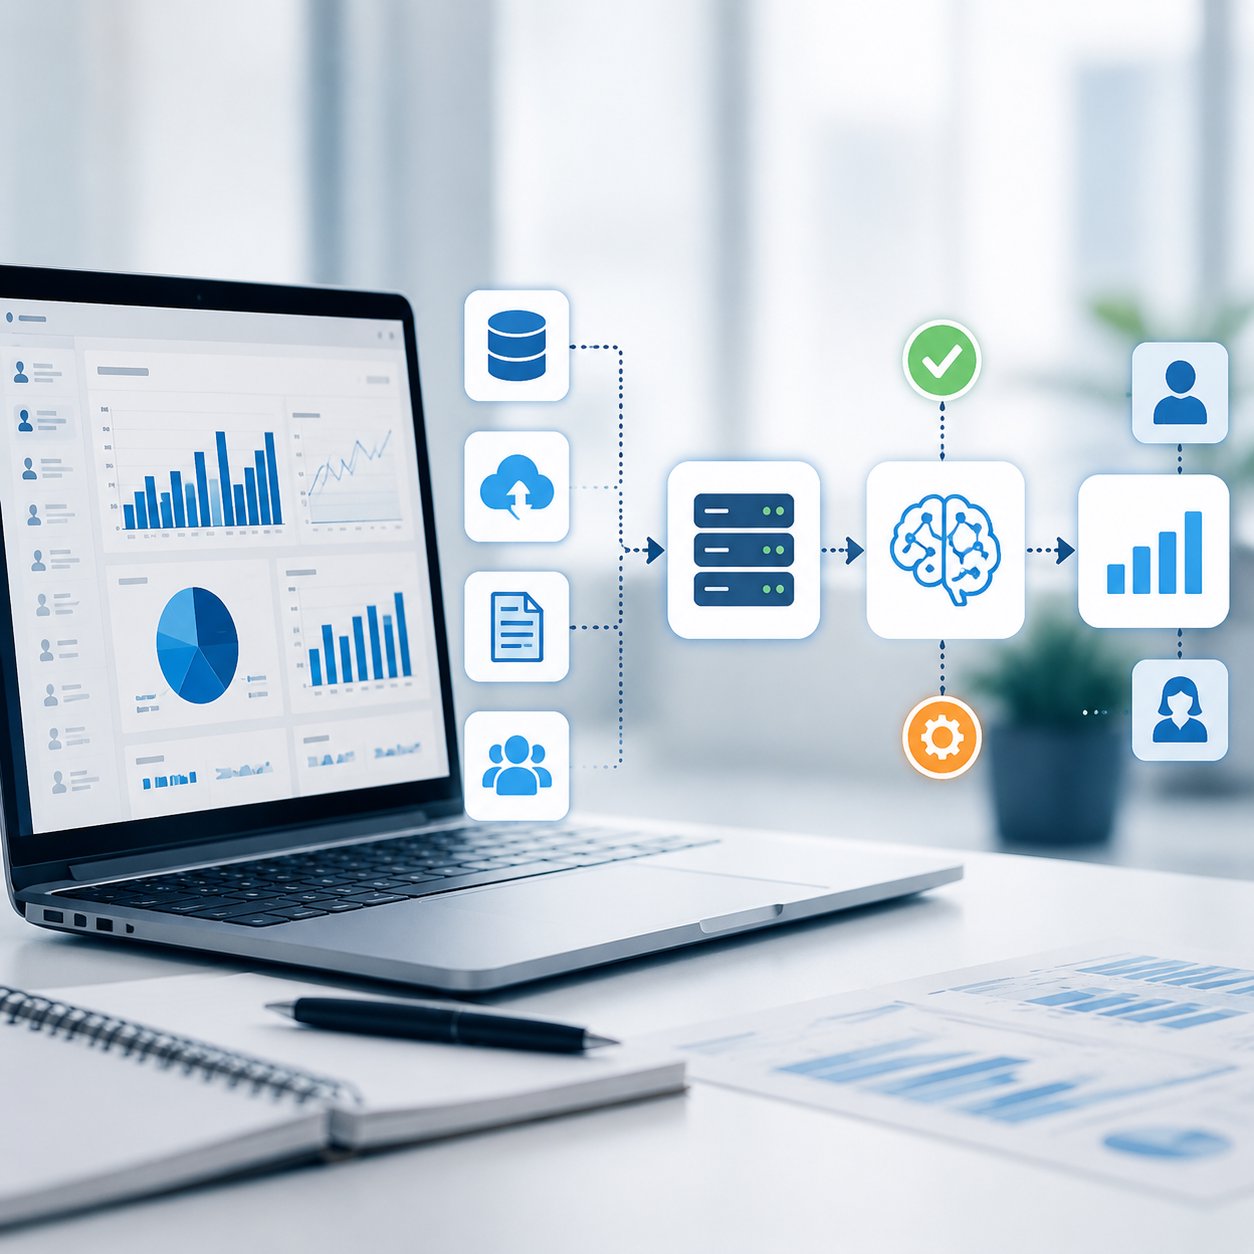
Sau khi làm sạch là bước hợp nhất. Dữ liệu khách hàng thường nằm rải rác ở nhiều nơi. Một phần ở CRM, một phần ở email marketing, một phần ở website. Đội tech cần kéo chúng về một kho chung. Khi đó mỗi khách hàng có một hồ sơ đầy đủ và nhất quán.
Kiến trúc thu thập và đồng bộ dữ liệu thời gian thực
Làm sạch dữ liệu cũ mới là một nửa câu chuyện. Phần còn lại là thu thập dữ liệu mới liên tục. Hành vi khách hàng thay đổi từng giờ. Một pipeline tốt phải bắt được những thay đổi đó gần như ngay lập tức.
Event tracking, webhook và message queue để đẩy hành vi khách về kho dữ liệu
Có ba kỹ thuật quen thuộc giúp dữ liệu chảy về kho theo thời gian thực. Chúng tôi sẽ giải thích từng cái một cách đơn giản.
Đầu tiên là event tracking, tức theo dõi sự kiện. Mỗi khi khách mở email, xem trang sản phẩm hay bấm nút, hệ thống ghi lại một sự kiện. Đây là nguyên liệu thô để mô hình hiểu hành vi.
Tiếp theo là webhook. Hãy hình dung webhook như một cú điện thoại tự động. Khi có sự kiện xảy ra ở một hệ thống, nó gọi ngay sang hệ thống khác để báo tin. Nhờ vậy dữ liệu không phải chờ đến cuối ngày mới đồng bộ.
Cuối cùng là message queue, hay hàng đợi tin nhắn. Khi lượng sự kiện đổ về quá nhiều cùng lúc, hàng đợi giúp xếp chúng lại có thứ tự. Hệ thống xử lý từ từ mà không bị nghẽn. Đây là chi tiết kỹ thuật quan trọng khi lưu lượng lớn.
Cân bằng giữa độ trễ thấp và chi phí hạ tầng khi luồng dữ liệu lớn dần
Mọi thứ nghe có vẻ lý tưởng. Nhưng có một sự đánh đổi bạn cần biết. Dữ liệu càng cập nhật nhanh thì hạ tầng càng tốn kém. Xử lý theo thời gian thực đòi hỏi máy chủ mạnh và luôn sẵn sàng.
Không phải dữ liệu nào cũng cần nhanh như nhau. Vì vậy đội tech nên phân loại. Một lời khuyên thực tế cho bạn:
- Dữ liệu cần phản ứng tức thì, như khách đang xem hàng, nên xử lý thời gian thực
- Dữ liệu phục vụ báo cáo, như tổng hợp tháng, có thể xử lý theo lô để tiết kiệm
- Luôn theo dõi chi phí hạ tầng khi luồng dữ liệu phình to theo thời gian
Cách làm này giúp bạn giữ độ trễ thấp ở nơi cần thiết. Đồng thời nó tránh đốt tiền vào nơi không cần.
Gắn lớp AI lên dữ liệu sale đã chuẩn hoá
Khi nền dữ liệu đã sạch và pipeline đã chạy ổn, bạn mới gắn lớp AI lên trên. Lúc này mô hình có nguyên liệu tốt để làm việc. Giá trị thực sự bắt đầu xuất hiện ở bước này.
Chấm điểm lead, gợi ý hành động và dự báo doanh số dựa trên dữ liệu sạch
Một ứng dụng AI cho phòng sale được nuôi bằng dữ liệu sạch có thể làm nhiều việc hữu ích. Nó giúp đội bán hàng tập trung đúng chỗ thay vì làm theo cảm tính.
Những việc phổ biến mà lớp AI hỗ trợ gồm:
- Chấm điểm lead: sắp xếp khách tiềm năng theo khả năng chốt đơn
- Gợi ý hành động: nhắc nhân viên nên gọi ai, gửi gì và khi nào
- Dự báo doanh số: ước lượng kết quả kỳ tới dựa trên xu hướng dữ liệu
Điểm chung của cả ba là chúng đều dựa trên dữ liệu nền. Nếu dữ liệu lệch, mọi gợi ý đều lệch theo. Đó là lý do chúng tôi luôn nhấn mạnh phần chuẩn hoá ở trên.
Tham khảo cách triển khai thực tế để hình dung kiến trúc đầu cuối
Lý thuyết là một chuyện, nhìn cách làm thật lại dễ hình dung hơn nhiều. Để thấy một kiến trúc đầu cuối hoàn chỉnh, bạn có thể tham khảo cách một đơn vị giàu kinh nghiệm về giải pháp số như mona.media triển khai phần mềm theo nhu cầu. Cách họ kết nối dữ liệu với mô hình là một ví dụ tốt để học hỏi.
Khi xem một triển khai thực tế, hãy chú ý vài điểm sau:
- Dữ liệu được làm sạch và hợp nhất ở đâu trong luồng
- Lớp AI nhận dữ liệu từ kho nào và theo nhịp ra sao
- Kết quả mô hình quay lại hỗ trợ nhân viên sale như thế nào
Kết luận: dữ liệu tốt là nền móng, AI chỉ là phần nổi
Sau tất cả, thông điệp rất rõ ràng. AI không phải phép màu. Nó chỉ là phần nổi trên một nền dữ liệu vững chắc. Phần chìm mới quyết định thành bại của ứng dụng AI cho phòng sale.
Dưới đây là tóm tắt hai cách tiếp cận để bạn dễ so sánh:
- Chất lượng kết quả: đầu tư AI trước thường kém ổn định vì dữ liệu bẩn; đầu tư dữ liệu trước đáng tin hơn nhờ nền dữ liệu sạch.
- Chi phí sửa về sau: làm AI trước có thể tốn kém vì phải sửa lại từ gốc; làm dữ liệu trước giúp xây đúng ngay từ đầu.
- Khả năng mở rộng: hạ tầng chắp vá sẽ khó mở rộng; pipeline có cấu trúc sẽ dễ phát triển hơn.
- ROI dài hạn: nếu dữ liệu chưa rõ, hiệu quả sẽ khó đo lường; nếu dữ liệu sạch, giá trị dài hạn rõ ràng hơn.
Vì vậy đội tech nên đầu tư vào pipeline dữ liệu trước, mô hình sau. Việc chuẩn hoá dữ liệu là bước đi đầu tiên có ROI rõ ràng nhất. Nó vừa giảm rủi ro vừa tạo nền cho mọi tính năng thông minh về sau.
Nếu bạn đang tìm hiểu để chuẩn bị cho bước chuyển đổi này, hãy bắt đầu từ dữ liệu của chính mình. Đánh giá xem CRM của bạn sạch đến đâu. Tìm hiểu thêm về cách dựng pipeline phù hợp với quy mô doanh nghiệp. Khi nền móng đã vững, việc gắn lớp AI sẽ trở nên đơn giản và đáng giá hơn rất nhiều.